📄 BAM与CRAM · MAF格式 · WGS测序文件内容 · GRanges对象 · 变异数据的字段GT、AD、DP · 基因组测序的数据格式缩写
测序机制
Illumina 短读长测序
核心原理:边合成边测序(Sequencing by Synthesis)
- 文库构建:将 DNA 随机打断成 200-600bp 片段,两端接上接头(adapter)
- 桥式扩增:片段固定在流动槽(flow cell)上,通过桥式 PCR 扩增形成簇(cluster),每个簇 = 同一片段的 ~1000 个拷贝
- 合成反应:每轮加入 4 种带荧光标记的可逆终止型 dNTP,掺入一个碱基并成像后,切除荧光基团和阻断基团,再进入下一轮
- 读长:NovaSeq X 系列支持包括 2×150 bp 在内的双端测序配置,具体读长和通量取决于流动槽与试剂配置
关键参数
| 概念 | 含义 |
|---|---|
| 覆盖度(Depth) | 每个碱基被测到的平均次数。WGS 通常 30-60×,WES 100-200× |
| 读长(Read length) | 每条 reads 的长度,PE150 = 双端各 150bp |
| 插入片段(Insert size) | 两个 reads 之间的实际 DNA 片段长度 |
其他平台
- PacBio / ONT(长读长测序平台):适用于结构变异、单倍型和全长转录本等分析
- 10x Genomics(文库与检测体系):提供单细胞和空间组学文库制备方案,所得文库通常仍需在兼容测序仪上读取
数据结构与文件格式
整个分析流的数据格式演变:
原始信号 → FASTQ → BAM/SAM → VCF/MAF → 下游分析表
FASTQ — 原始测序数据
@SEQ_ID
GATTTGGGGTTCAAAGCAGTATCGATCAAATAGTAAATCCATTTGTTCAACTCACAGTTT
+
!''*((((***+))%%%++)(%%%%).1***-+*''))**55CCF>>>>>>CCCCCCC65
每条 read 4 行:ID、序列、+、质量值。一个 WGS 样本通常产生数百 GB 的 FASTQ。质量分数为 Phred quality score,编码每个碱基的测序可信度。
SAM/BAM — 比对结果
SAM(文本)和 BAM(二进制压缩)存储 reads 比对到参考基因组的结果。
核心字段:
| 列 | 含义 | 示例 |
|---|---|---|
| QNAME | read 名 | SEQ_ID |
| FLAG | 比对状态标志 | 99 = paired, mapped, proper pair |
| RNAME | 参考染色体 | chr1 |
| POS | 比对起始位置 | 10000 |
| MAPQ | 比对质量 | 60 |
| CIGAR | 比对操作串 | 150M = 150bp 完全匹配 |
| SEQ | 碱基序列 | |
| QUAL | 质量值 |
索引:.bai 文件,支持随机访问任意基因组区间。
VCF — 变异检测结果
存储 SNV、Indel、SV 等变异信息。
#CHROM  POS     ID  REF  ALT  QUAL  FILTER  INFO           FORMAT       SAMPLE
chr1    12345   .   A    G    60    PASS    DP=50;AF=0.5   GT:AD:DP:GQ  0/1:25,25:50:99
REF/ALT:参考/变异碱基AF:变异等位基因频率GT:AD:DP:基因型、等位基因深度、总深度
体细胞突变 VCF vs 胚系 VCF:前者只存肿瘤特异突变,后者存个体遗传变异。
MAF — 突变注释格式
VCF 的"扁平化"版本,每行一个突变,已注释好基因、突变类型、临床意义等。TCGA 项目广泛使用。
拷贝数相关格式
- Battenberg 输出:等位基因特异性拷贝数(major/minor CN per segment)
- Segment 文件:
chr start end total_CN的分段表
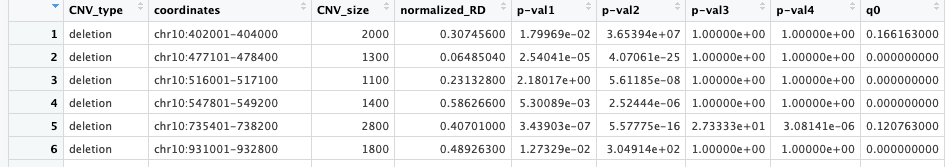
CNV 结果表通常还会给出分段坐标、片段长度、标准化读深和质量统计量,具体字段定义依赖上游软件。
数据流全景(肿瘤 WGS)
样本 → DNA提取 → 文库构建 → 测序仪
                                ↓
                            FASTQ (原始reads)
                                ↓
                         BWA-MEM 比对
                                ↓
                          BAM (比对结果)
                         ↙        ↘
               突变检测(Strelka2/MuTect2)    拷贝数(Battenberg)
                        ↓                        ↓
                      VCF/MAF              Segment/CN profile
                        ↓                        ↓
                  亚克隆聚类(dpclust/PyClone) ← CCF
                        ↓
                  进化树 + MRCA估计(MutationTimeR)
关键数据结构(代码层面)
| 结构 | 语言 | 用途 |
|---|---|---|
GRanges (Bioconductor) |
R | 基因组区间操作(chr:start-end + 元数据) |
GAlignments |
R | 读取 BAM 文件 |
VariantAnnotation |
R | 读取 VCF |
pysam |
Python | 读写 BAM/VCF 的 Python 接口 |
AnnData |
Python | 单细胞数据矩阵(cells × genes) |
关联条目
- 突变特征 — 突变特征分析依赖 VCF 中的 SNV/Indel 数据
- 肿瘤进化与异质性 — 亚克隆重建依赖 BAM → CCF → 聚类流程
- DNA 双链断裂修复与同源重组 — DSB 修复缺陷影响突变谱和拷贝数模式
参考资料
原创
基因组测序与数据格式
本文采用 CC BY-NC-SA 4.0 许可协议,转载请注明出处。
评论交流
欢迎留下你的想法